Les requêtes que personne ne voit
Sur plusieurs environnements clients que je suis, une partie des requêtes est bloquée pour des raisons de sécurité. Le service continue de fonctionner, les utilisateurs passent leurs commandes, et cette activité reste hors de leur champ de vision. Elle mérite pourtant une place dans les décisions de l’entreprise : la sécurité opérationnelle doit pouvoir prévenir, corriger et vérifier en continu.
Les recherches automatisées de systèmes vulnérables n’exigent pas de connaître le nom de l’entreprise. Un programme peut parcourir des adresses et essayer des chemins connus, à la recherche d’une installation oubliée ou d’un logiciel exposé. Une PME peut donc recevoir ces requêtes sans faire l’objet d’un ciblage individuel. Attendre de devenir une cible « intéressante » laisse de côté ce fonctionnement ordinaire.
Lire ces traces demande de la précision. Cloudflare rappelle qu’une requête HTTP peut produire plusieurs événements de sécurité. Diviser un total d’événements par un total de requêtes ne suffit donc pas à mesurer une proportion de requêtes bloquées. Et un blocage peut aussi être un faux positif à examiner.
Un scan cherche une ouverture. Une tentative d’exploitation essaie d’utiliser une faille. Une exploitation démontrée établit qu’un mécanisme fonctionne dans des conditions données. Une compromission suppose qu’un système a effectivement été atteint. Le nombre de tentatives reçues ne permet pas de sauter d’une catégorie à la suivante.
Les alertes du 1er au 27 octobre 2026 montrent surtout combien de couches il faut suivre pour maintenir un service. « En cascade » décrit ici leur succession, sans supposer une chaîne d’exploitation commune.
Un mois qui oblige à regarder plusieurs couches
Le code de l’application repose sur un moteur d’exécution, des bibliothèques, un système et des outils de livraison. Une équipe qui ne surveille que son propre dépôt laisse une partie de cet ensemble sans suivi.
| Date en octobre 2026 | Composant et problème | Conséquence opérationnelle |
|---|---|---|
| 1er | Ubuntu USN-8861-1 : OpenSSL sur Ubuntu 26.04 LTS, épuisement possible de ressources via QUIC. | Vérifier les usages concernés et appliquer les paquets corrigés. |
| 13 | Ubuntu USN-8917-1 : bulletin noyau pour Ubuntu 24.04 LTS. | Identifier la variante du noyau et suivre les instructions du fournisseur. |
| 21 | Node.js, faille Brotli dite Node2Shell : décompression de données malformées, corruption mémoire pouvant conduire à une exécution de code. | Examiner les chemins qui décompressent des données non fiables avec node:zlib, puis mettre à jour. |
| 21, complément le 23 | PHP2Shell : deux failles critiques du runtime permettant une exécution de code à distance sans authentification. | Mettre à jour PHP et examiner le complément de configuration. |
| 21, bilan le 23 | LiteLLM 1.107.0 : publication compromise sur PyPI et les registres de conteneurs. | Rechercher les artefacts utilisés et traiter les environnements exposés selon l’avis d’incident. |
| 23 | Ruby et les CVE GitLab : corruption mémoire lors de la compilation de certaines expressions régulières. | Vérifier si un attaquant contrôle les motifs compilés et appliquer les corrections. |
Ces lignes ne signifient pas que chaque application est exploitable. Pour Ruby, utiliser des expressions écrites par les développeurs ne suffit pas à remplir la condition d’exposition décrite. LiteLLM illustre une dépendance malveillante distribuée par un canal légitime, sans constituer une faille du langage Python.
Le complément PHP du 23 concerne une combinaison inhabituelle de configuration et de changement du sérialiseur de session à l’exécution. Celui du 26 ajoute des paquets Windows reconstruits avec Brotli corrigé. Le même numéro de runtime ne suffit donc pas à identifier ce paquet.
Enfin, une date de bulletin n’est pas une date de découverte : USN-8917-1 regroupe notamment une CVE de 2023. Compter ces entrées comme autant de nouvelles failles d’octobre fausserait le constat.
Le volume des failles publiées augmente
Le programme CVE attribue des identifiants communs aux vulnérabilités rendues publiques. Ses statistiques officielles de publication permettent de comparer des périodes identiques : 23 710 fiches au premier semestre 2025, contre 35 872 au premier semestre 2026, soit une hausse de 51,3 %.
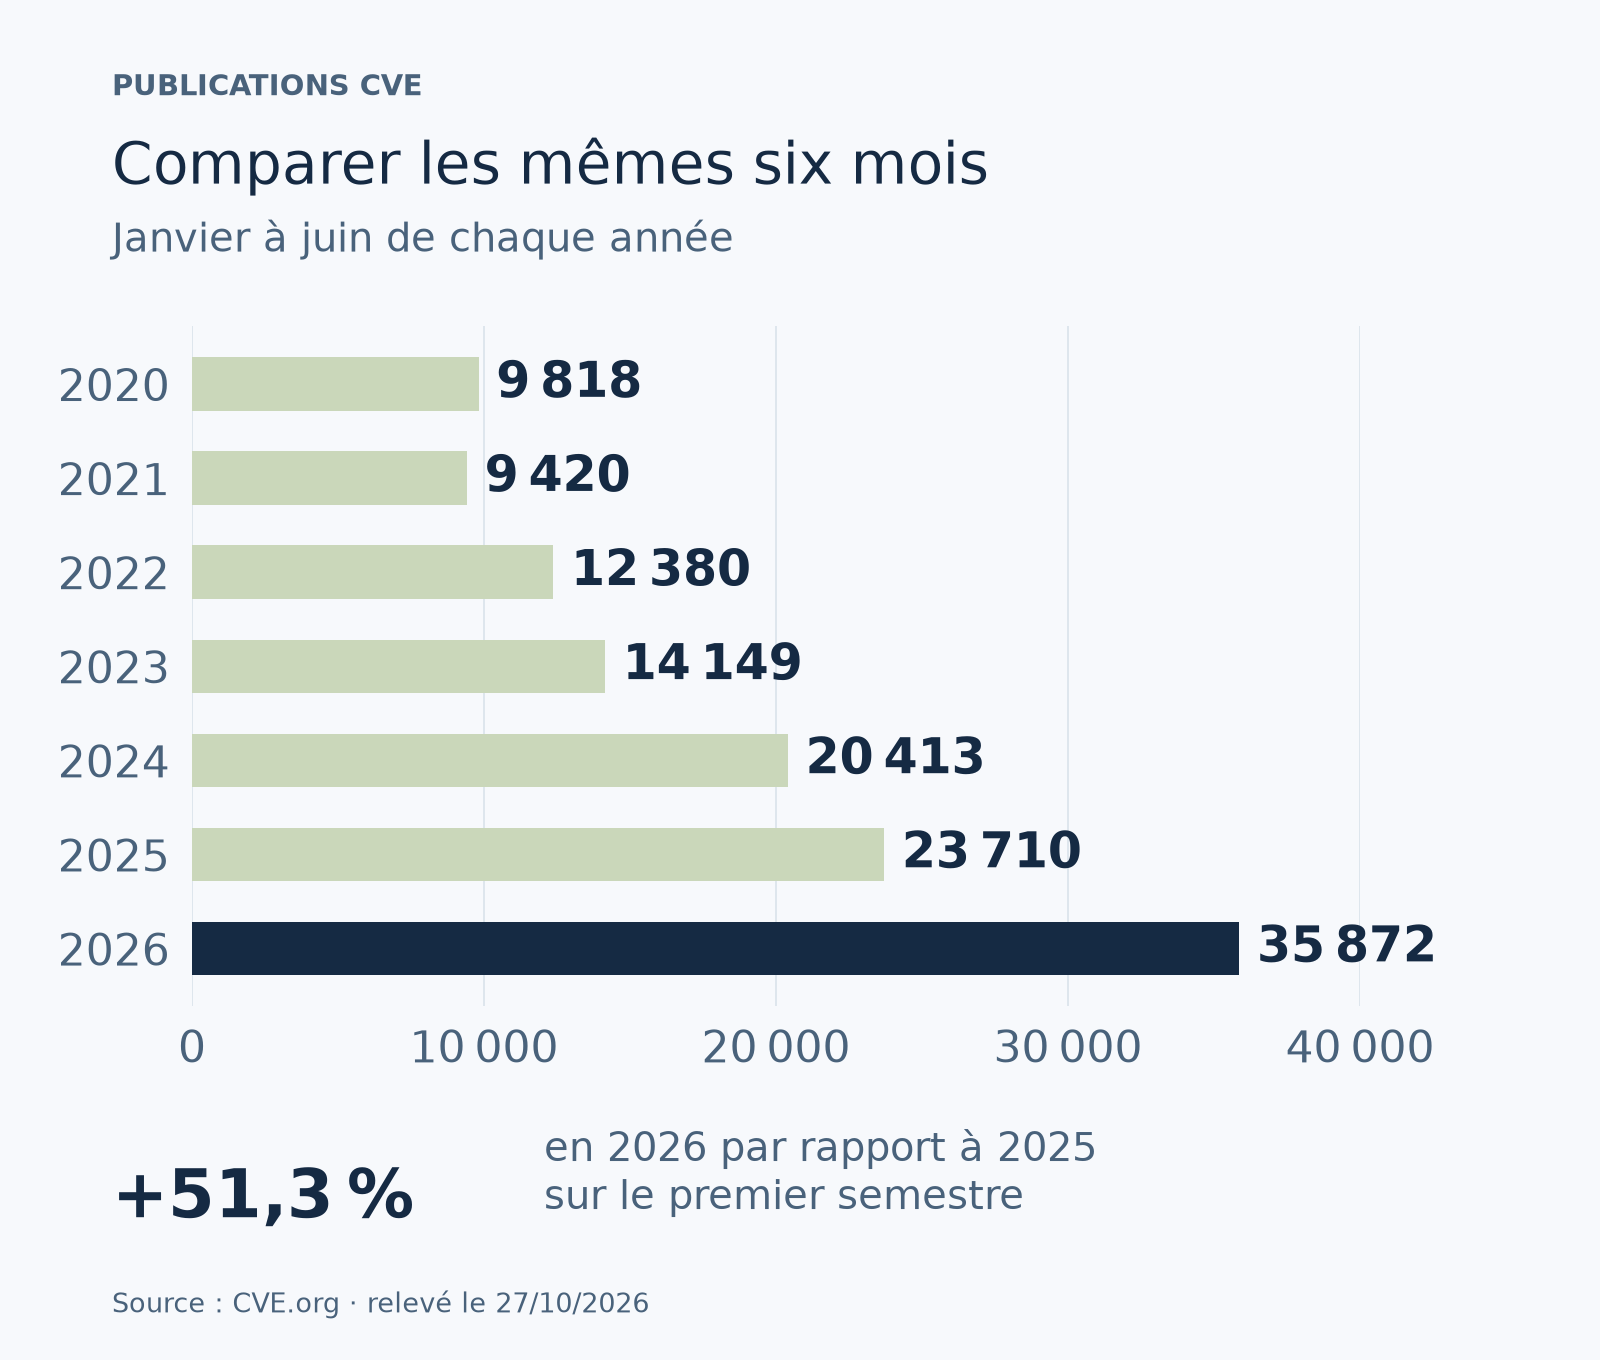
Graphique redessiné à partir des totaux des premier et deuxième trimestres. Source consultée le 27 octobre 2026, sans projection des mois suivants.
Ces publications mesurent le volume des vulnérabilités documentées, pas celui des attaques ou des compromissions. Leur nombre dépend aussi de la couverture du programme et du travail de signalement. La hausse ne démontre donc pas, à elle seule, que les logiciels deviennent moins sûrs. Elle renforce une exigence pratique : pouvoir trier ce qui concerne l’entreprise et traiter les alertes retenues.
Le délai de réaction devient déterminant
Dans son observation publiée le 21 octobre, AWS situe une tentative PHP2Shell contre ses capteurs MadPot au 17 octobre, avant la divulgation du 21. Après la publication des correctifs, de nouveaux exploits ont été utilisés contre ses capteurs presque immédiatement. AWS précise ne pas savoir si ces tentatives auraient réussi sur des systèmes réels.
Cette chronologie change le point de départ d’une investigation. Vérifier seulement ce qui s’est passé après l’avis peut manquer une activité antérieure. Corriger ferme une possibilité pour la suite, mais ne répond pas à la question de ce qui a déjà eu lieu.
Le constat d’Anthropic du 8 octobre porte sur un autre maillon : le coût de l’exploitation baisse tandis que vérifier, divulguer et corriger reste lent et dépend des personnes. C’est l’analyse d’un acteur de l’IA. Elle ne démontre ni que toutes les tentatives observées utilisent l’IA, ni que chaque découverte deviendra une attaque réussie.
Pour une équipe, la conséquence est très concrète. Une alerte reçue vendredi ne sera utile que si quelqu’un peut déterminer les services concernés, décider d’une mesure et la livrer. Une boîte mail de veille sans responsable ni accès de déploiement ne crée pas cette capacité. Le temps perdu à retrouver le serveur ou le prestataire se consomme pendant que le service reste exposé.
Cinq capacités à financer et à faire fonctionner
Un audit ponctuel donne un état et des priorités. Il peut révéler une situation dangereuse et justifier un chantier urgent. La question suivante est celle du fonctionnement après sa restitution : qui prend la prochaine alerte, avec quels moyens et quelle preuve de résolution ? La sécurité applicative et opérationnelle couvre précisément cette continuité entre le logiciel et son exploitation.
Savoir ce qui tourne et à qui cela appartient
Le responsable technique doit pouvoir rattacher un service à son propriétaire, à ses versions déployées et à ses dépendances. L’inventaire inclut les serveurs, les conteneurs, les services achetés, les tâches planifiées et les outils de construction. Un fichier de dépendances dans Git renseigne une intention. Il faut aussi savoir quel artefact fonctionne réellement en production.
La preuve utile est un inventaire daté, relié aux déploiements, dont un échantillon peut être comparé au fonctionnement réel. Quand un avis arrive, l’équipe doit retrouver les instances concernées sans lancer une enquête sur toute l’entreprise. Si un prestataire les gère, son périmètre et son contact d’urgence doivent être disponibles.
Réduire les expositions et les privilèges
Le responsable de l’exploitation, avec les propriétaires applicatifs, examine ce qui doit rester accessible et les droits nécessaires à chaque service. Une interface d’administration inutilisée peut être fermée. Un jeton qui sert à lire un dépôt n’a pas besoin de pouvoir modifier toute l’organisation.
L’article sur les accès qui survivent aux outils montre pourquoi cette revue doit aussi suivre les usages abandonnés. La preuve attendue est le retrait vérifié d’un accès ou d’une exposition, avec la liste de ce qui reste autorisé et sa justification. Une consigne de révocation sans contrôle de son application laisse le travail inachevé.
Transformer la veille en décisions
Une personne nommée reçoit les avis fournisseurs et les alertes sur les dépendances. Le responsable technique arbitre ensuite selon la version, le chemin exploitable, les données accessibles et l’exposition réelle. Le score de gravité aide au tri, sans remplacer ces vérifications.
Chaque alerte importante doit laisser une décision traçable : concerné ou non, sur quelle preuve, quelle mesure, qui agit et quand réexaminer. Une incertitude reste ouverte avec un responsable. La ranger dans « non concerné » faute d’information fait disparaître le suivi sans réduire le risque. La direction doit savoir qui tranche lorsqu’une correction urgente interrompt le programme produit.
Corriger jusqu’au service réellement déployé
L’équipe de développement prépare et teste le changement, l’exploitation assure sa livraison, et un responsable désigné vérifie le résultat. Selon l’organisation, ces rôles peuvent être portés par les mêmes personnes. Ils doivent néanmoins couvrir toute la chaîne, y compris les processus anciens encore actifs et les instances qu’un déploiement n’a pas remplacées.
La preuve rassemble la version ou le paquet corrigé, le déploiement effectué, les redémarrages nécessaires et le contrôle du service après intervention. Un test fonctionnel vérifie que les utilisateurs peuvent encore travailler. Le contrôle de version ou de configuration vérifie la correction visée. Un pipeline vert ne démontre pas, à lui seul, ces deux résultats en production.
Détecter une intrusion et pouvoir reprendre
L’exploitation ou le prestataire de sécurité doit recevoir des signaux exploitables : créations de comptes inhabituelles, processus inattendus, modifications de fichiers ou accès suspects aux secrets, selon le système. Une personne doit pouvoir les examiner et déclencher la réponse. Les journaux doivent être conservés assez longtemps pour l’investigation prévue et protégés contre leur disparition avec le serveur.
La direction valide aussi ce que l’entreprise doit pouvoir restaurer, dans quel délai et avec quelle perte de données acceptable. La preuve est un exercice de restauration daté, avec durée mesurée et vérification des données et fonctions récupérées. Un compte rendu d’exercice doit montrer qui isole le système, préserve les traces et révoque les secrets compromis. Une sauvegarde dont personne n’a testé la lecture laisse ces réponses inconnues.
La reconstruction après un WordPress compromis montre comment ces vérifications se traduisent après un incident.
Les mises à jour ont un coût, l’attente aussi
La crainte de casser la production est légitime. Une mise à jour peut perturber les paiements, les échanges avec un partenaire ou un traitement de nuit. L’entreprise doit réserver du temps de maintenance et disposer d’un environnement de test suffisamment proche du service réel. Demander des correctifs immédiats tout en remplissant chaque créneau de nouvelles fonctionnalités rend cet engagement difficile à tenir.
La réponse consiste à prioriser. Un chemin exploitable sur un service public appelle une décision plus rapide qu’un composant absent de la production. Quand le correctif ne peut pas être livré immédiatement, une fermeture temporaire ou une restriction d’accès peut réduire l’exposition. Sa portée, ses conséquences et sa date de fin doivent être explicites. Une mesure provisoire ne doit pas disparaître du suivi parce que l’urgence médiatique est passée.
Préparer le retour arrière protège la disponibilité, mais revenir à une version vulnérable rouvre le problème. Il faut donc prévoir comment garder une restriction ou suspendre la fonction concernée si le déploiement échoue. Ce compromis se décide avec le métier, avant l’intervention lorsque c’est possible.
Un pare-feu applicatif peut filtrer certaines tentatives pendant ce travail. Il ne met pas à jour le runtime, ne révoque pas un secret déjà volé et ne couvre pas nécessairement un téléchargement sortant ou un outil de construction. Son tableau de bord renseigne une partie de la défense, avec un périmètre à comprendre.
Trois questions auxquelles obtenir une réponse
Un dirigeant n’a pas à lire chaque bulletin ni à choisir lui-même les versions. Il doit obtenir des réponses qu’il peut faire vérifier.
- Sommes-nous concernés ? Sur quels services, quelles versions et quels chemins d’entrée repose la réponse ? Que reste-t-il inconnu ?
- Qui peut intervenir et sous quel délai ? Qui décide, qui déploie, qui prend le relais en cas d’absence et quel travail sera reporté ?
- Comment vérifions-nous la correction et une éventuelle intrusion antérieure ? Quelles preuves confirment le service corrigé, quelles traces couvrent la période d’exposition et qui les examine ?
Lorsque ces réponses manquent, un diagnostic technique et organisationnel peut établir les lacunes et ordonner les premiers travaux. Il faudra ensuite leur attribuer un responsable, du temps et un suivi. Les alertes d’octobre rendent visible une exigence durable : l’entreprise doit pouvoir réagir à la suivante alors que ses clients continuent d’utiliser le service.